
Was macht einen guten KI-Agenten im Kundenservice aus?
Ein guter KI-Agent im Kundenservice leistet im Grunde genommen die Aufgabe eines Ersthelfers: Er handelt sofort und übergibt an Fachleute, sobald ein Fall ihn überfordert. Er fängt die einfachen Anfragen auf und reicht weiter, was nur ein Mensch lösen kann.
Natürlich hinkt das Bild ein wenig: Routinefälle kann der Agent selbst zu Ende bringen. Und er wird besser, wenn regelmäßig jemand hineinschaut und die Prozesse verbessert. Genau wie neue Kollegen besser werden, wenn sie ehrliche und konstruktive Rückmeldungen bekommen.
Oft ist es jedoch so, dass Zuständigkeiten nach Go-Live nicht genau definiert sind und klare Verantwortliche fehlen, die sich genau mit diesem regelmäßigen Hineinschauen beschäftigen und die Agenten kontinuierlich verbessern.
Was also macht einen guten KI-Agenten im Kundenservice aus und wie können Sie ihn verbessern?
Was passiert mit dem Agenten nach dem Go-live?
Wie man einen KI-Agenten auswählt und einführt, erklären viele Leitfäden. Über die Zeit nach dem Go-live steht dort wenig, obwohl “live” eben nicht “fertig” heißt.
Der Weg dorthin sieht häufig ähnlich aus: Ein Fachbereich meldet seinen Bedarf, das Produktteam beauftragt einen Dienstleister, und nach einigen Monaten geht der Agent live. Oft betreut ein kleines zentrales Team die Agenten mehrerer Marken oder Länder. IT und Dienstleister liefern, was beauftragt war. Nur endet der Auftrag häufig mit dem Go-live oder umfasst danach allein den Betrieb.
Ab dann kümmert sich jede Seite um ihren Teil. IT oder Dienstleister halten den Agenten am Laufen. Das Produktteam plant die nächsten Use Cases. Der Fachbereich wendet sich dem nächsten Thema zu, und der Service betreut die Kunden. Ob das Team mit dem Agenten auf dem richtigen Weg ist und was es besser machen kann, beurteilt dann jede Seite für sich.
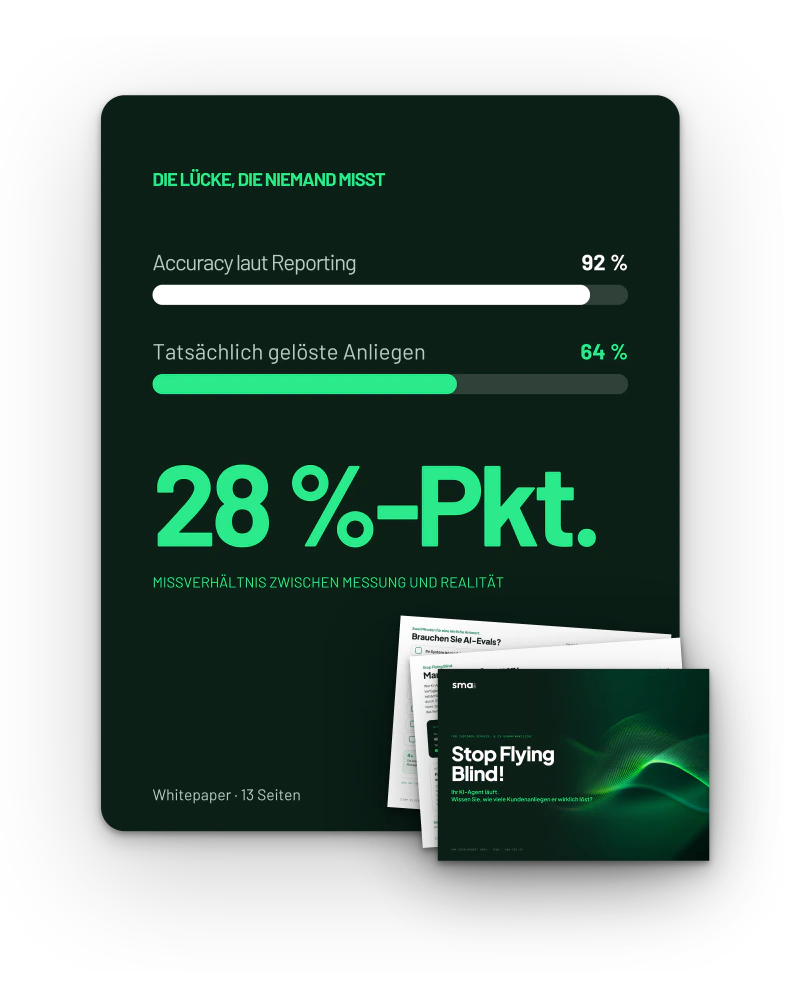
Gemessen wird vor allem, was sich leicht erfassen lässt: Verfügbarkeit, Antwortzeit, Kosten. Wie viele Anliegen der Agent aus Kundensicht löst, steht in diesen Zahlen nicht. Es kommt immer wieder vor, dass ein Agent neun von zehn Fragen sachlich korrekt beantwortet. Für den Kunden zählt aber, ob sein Anliegen danach erledigt ist. Wie sich diese Lücke für Sie anfühlt, hängt von der Seite ab, auf der Sie stehen.
Was ist nötig, um einen Kundenservice-Agenten kontinuierlich weiterzuentwickeln?
Die Stellschrauben, um die Qualität zu beurteilen und weiterzuentwickeln, sind: Anforderungen, Prioritäten im Backlog und die Aufträge an den Dienstleister. Und diese Stellschrauben werden gerade wichtiger. KI-Agenten übernehmen zunehmend anspruchsvollere Anliegen und stoßen Vorgänge selbst an, etwa eine Umbuchung oder eine Erstattung. Damit wächst der Wert jeder richtigen Entscheidung, die Sie für den Agenten und seine Roadmap treffen.
Die Chats des Agenten liegen vor, sind aber schlicht zu viele, um sie von Hand zu lesen. Aufmerksamkeit bekommen deshalb vor allem Einzelfälle: eine Beschwerde aus dem Fachbereich, eine Beobachtung aus dem Service. Wie oft der Agent danebenliegt und warum, beleuchten aber diese Rückmeldungen selten systematisch. Doch genau das wäre nötig, um dem Dienstleister einen klaren Auftrag zu geben und zu prüfen, ob alle Gewerke ihren Teil zum gemeinsamen Ziel beitragen.
Was wissen Sie bereits über Ihren Agenten?
Wie gut der Agent arbeitet, steht in seinen Chats. Einen Teil davon kennen Sie und der Service aus dem Alltag: der Service aus Wiederanrufen und Beschwerden, Sie aus dem, was Sie beim Dienstleister beauftragen. Wo dieses Wissen endet, zeigen sechs Fragen. In Klammern steht, wer am ehesten eine Antwort hat.
- Wie viele Umbuchungen hat der Agent tatsächlich abgeschlossen und bei wie vielen hat er nur korrekt geantwortet? (Service- und Produktteam)
- Wie reagiert der Agent, wenn ein Kunde wütend wird? (Service)
- Antwortet er aus Ihren aktuellen Kulanzregeln oder aus dem Modellwissen? (Produktteam und Dienstleister)
- Sagt er „Das weiß ich nicht“, wenn eine Information nicht in seinen Daten steht, oder erfindet er eine Antwort? (Produktteam und Dienstleister)
- Deckt seine Antwort Umbuchung und Erstattung ab oder nur den erstbesten Aspekt? (Service)
- Übergibt er zuverlässig an Ihr Service-Team, solange der Kunde noch im Gespräch ist? (Service- und Produktteam)
Die erste Frage ist die Lücke zwischen „korrekt beantwortet“ und „erledigt“. Gehen Sie die Fragen gemeinsam mit dem Service durch und vermerken Sie bei jeder „wissen wir“, „vermuten wir“ oder „wissen wir nicht“. Alle Fragen ohne „wissen wir“ sind die offenen Punkte für Ihre erste gemeinsame Runde.
Wie klären Sie die offenen Punkte?
Am besten bekommt das Thema einen festen Tagesordnungspunkt in einem bestehenden Jour fixe. Dazu kommen Service und Produktteam, IT oder Dienstleister und eine Person aus dem Fachbereich, die über Prioritäten, Budget und Ressourcen entscheiden kann. So sitzen alle an einem Tisch, die den Agenten nach dem Go-live beeinflussen.
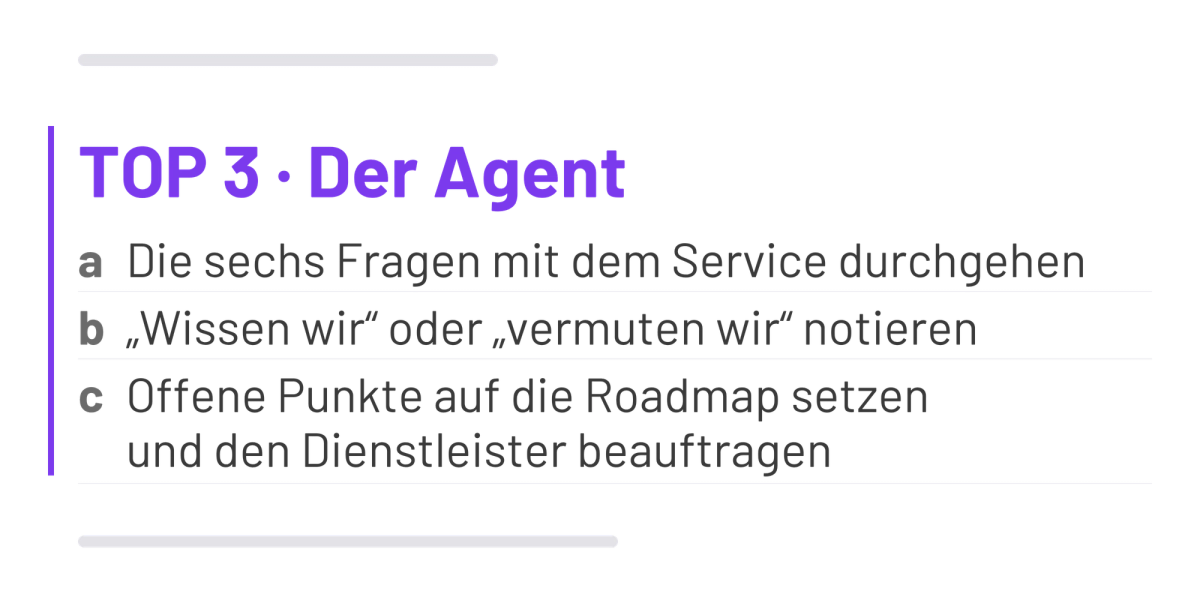
Beim ersten Mal sortiert die Runde die offenen Punkte aus den sechs Fragen und klärt für jeden, wie gesichert die Antwort ist. Als Default hilft: Jede Antwort gilt als Vermutung, bis jemand einen Beleg zeigt.
Für manche Punkte reichen vorhandene Zahlen aus Service und Betrieb. Andere brauchen eine systematische Auswertung der Chats, etwa die Frage, ob der Agent aus Ihren Quellen antwortet. Aus dem Kundenservice kennt man dafür das Prinzip vom Mystery Shopping: Ein unabhängiger Dritter prüft, was Kunden erleben. AI-Evals übertragen dieses Prinzip auf den Agenten und beantworten das „Wie oft“ und das „Warum“. Bestandsaufnahme, Tests, Freigabe und laufende Beobachtung bilden dabei einen Kreislauf. Die Rolle des unabhängigen Dritten kann eine unabhängige KI-Beratung übernehmen.
Ab dann steht der Agent bei jedem Jour fixe auf der Agenda, und die nächsten offenen Punkte wandern auf die Roadmap. Der Dienstleister bekommt klare Aufträge, und alle Beteiligten sehen, was ihr Gewerk zum gemeinsamen Ziel beiträgt. Damit hat das regelmäßige Hineinschauen einen festen Platz und feste Verantwortliche.
Häufige Fragen zur Verbesserung von KI-Agenten im Kundenservice
Was macht einen guten KI-Agenten im Kundenservice aus?
Er erledigt Routineanliegen selbst und übergibt rechtzeitig an das Service-Team, wenn ein Fall ihn überfordert. Besser wird er, wenn jemand regelmäßig in seine Chats schaut und nachjustiert.
Wie kann man einen KI-Agenten im Kundenservice verbessern?
Verbessern können Sie den Agenten dort, wo Sie wissen, wie oft er danebenliegt und warum. Gehen Sie dafür mit dem Service sechs Fragen durch, etwa wie viele Umbuchungen der Agent tatsächlich abschließt und nicht nur korrekt beantwortet. Vermerken Sie bei jeder Frage „wissen wir“, „vermuten wir“ oder „wissen wir nicht“. Die offenen Punkte klärt ein fester Tagesordnungspunkt im bestehenden Jour fixe, und daraus entstehen Einträge auf der Roadmap und klare Aufträge an den Dienstleister.
Was ist der Unterschied zwischen „korrekt beantwortet“ und „gelöst“?
Eine Antwort kann sachlich stimmen und das Anliegen trotzdem verfehlen. Gelöst ist ein Anliegen erst, wenn der Kunde danach nichts mehr tun muss, etwa weil die Umbuchung tatsächlich abgeschlossen ist.
Wer sollte im Jour fixe zum KI-Agenten dabei sein?
Service- und Produktteam, IT oder Dienstleister und eine Person aus dem Fachbereich, die über Prioritäten, Budget und Ressourcen entscheidet.
Was hat Mystery Shopping mit KI-Agenten zu tun?
Beim Mystery Shopping prüft ein unabhängiger Dritter, was Kunden erleben. AI-Evals übertragen dieses Prinzip auf den Agenten: Sie zeigen, wie oft er danebenliegt und warum.
Aus dem Blog
Weitere Insights & Aktuelles.
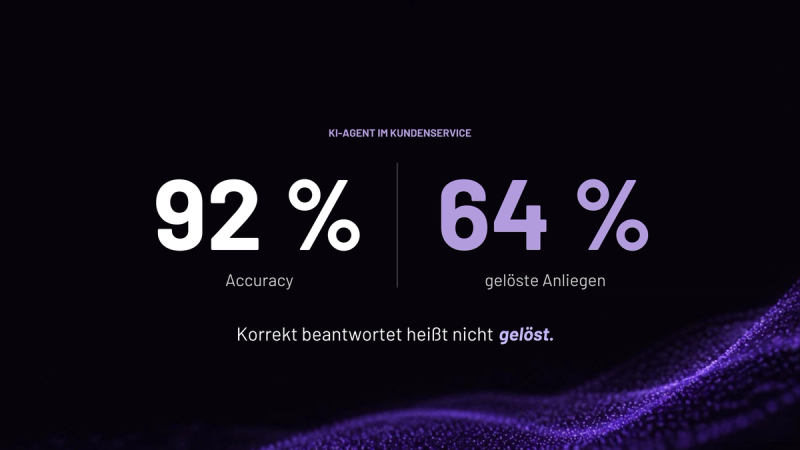
KI-Agent im Kundenservice: Qualität nach dem Go-live prüfen
Ihr KI-Agent im Kundenservice antwortet schnell und sachlich richtig. Trotzdem rufen Kunden danach an. Wer prüft, ob er Anliegen wirklich löst? Sechs Fragen und eine Routine für Service, Produktteam und IT.
Mehr lesen→
AI Evals: Fünf Dimensionen für produktive KI-Systeme
Im laufenden Betrieb Ihres KI-Systems fallen Ihnen drei Dinge auf. Der Token-Verbrauch steigt von einem Sprint zum nächsten um 40 %, ohne dass eine Konfigurationsänderung das erklären würde. Nach einem Prompt-Update verändert sich die Antwortqualität spürbar; das Team empfindet sie als schlechter, kann aber nicht benennen, warum. Und Ihr RAG-System liefert Aussagen, die in keinem […]
Mehr lesen→
LLM-Halluzinationen: Warum korrekte Daten das Problem nicht lösen
Ein KI-System hat die AGB Ihres Unternehmens vollständig geladen. Es kennt jeden Paragraphen. Und trotzdem verspricht es einem Kunden eine Leistung, die rechtlich nicht gedeckt ist. Das passiert täglich in Systemen, die längst als produktionsreif gelten. Der Grund liegt nicht im fehlenden Datenzugriff. Er liegt darin, wie das Modell mit den Daten umgeht. Was ist […]
Mehr lesen→
Fehlerfreie KI-Anwendungen entwickeln: Die Vorteile von AI-Evaluations
Die Herausforderungen in KI-Projekten verschieben sich drastisch: Wir sprechen nicht mehr von Systemabstürzen, sondern vom sogenannten „Silent Failure“. Anwendungen liefern technisch einwandfreie Datenpakete aus, während der inhaltliche Kern zu halluzinieren beginnt, Compliance-Richtlinien verletzt werden oder die Markenreputation durch einen falschen Tonfall gefährdet wird. Technisch gesehen ist das System ein Erfolg. Der Live-Betrieb liefert jedoch andere […]
Mehr lesen→
Glossar: RAG-Systeme, Embeddings und KI-Evaluationen verstehen
Warum dieses Glossar? In fast jedem Discovery-Gespräch passiert dasselbe: Der Entscheider nickt bei ‚RAG‘, aber meint etwas anderes als der Entwickler im selben Raum. Dieses Glossar soll hier Abhilfe schaffen.
Mehr lesen→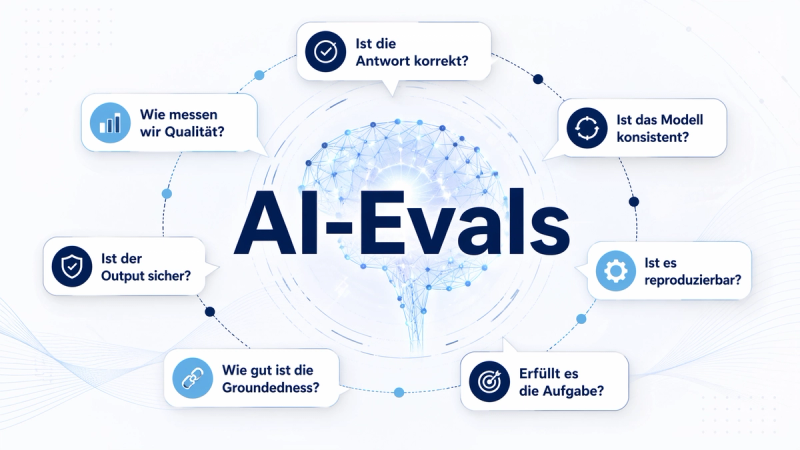
Effizienzsteigerung durch KI-Qualität: Was sind AI-Evaluations (AI-Evals)?
Die beeindruckende Geschwindigkeit, mit der KI-Prototypen heute entstehen, markiert den Beginn einer neuen Ära betrieblicher Effizienz. Doch der
Mehr lesen→